APPLIED ARTIFICIAL INTELLIGENCE
Soluții AI & RAG. Inteligență ancorată în datele companiei.
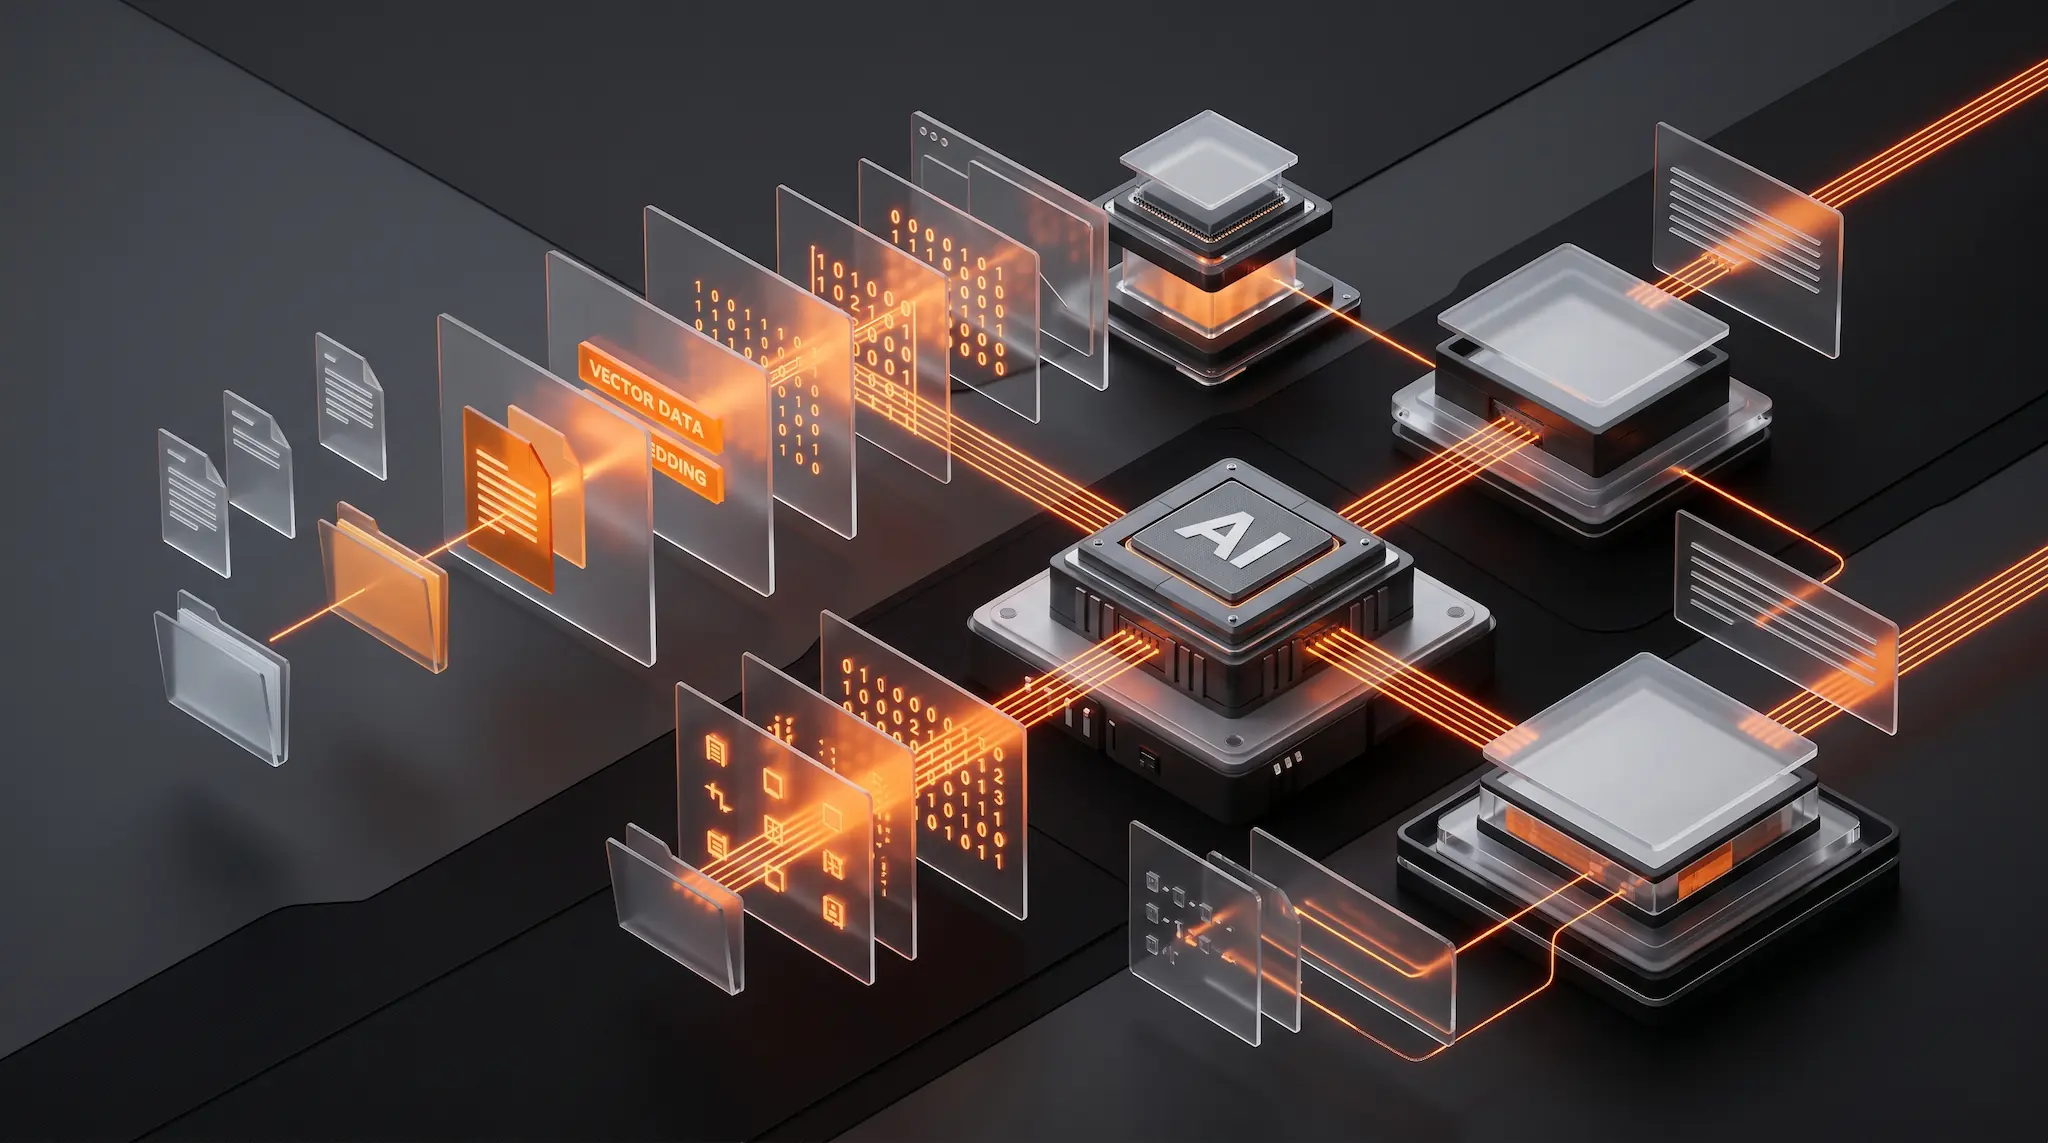
Depășim limitările modelelor de limbaj standard prin arhitecturi Retrieval-Augmented Generation (RAG). Indexăm, vectorizăm și interogăm securizat documentația internă a companiei tale, oferind asistenților AI un context privat și precis. Restrângem răspunsurile la corpusul tău de date și cităm sursa fiecărei afirmații, astfel încât un răspuns greșit se vede imediat, nu după ce a ajuns la client. Construim pipeline-ul complet — ingestie, embeddings, vector search, reranking și orchestrare LLM — integrat în aplicațiile pe care echipa ta le folosește deja. Stack provider-agnostic: comuți între Claude, GPT sau modele open-source self-hosted fără să rescrii arhitectura.
Blocaje pe care le eliminăm
Halucinații și răspunsuri inventate
Modelele standard inventează date când nu știu. Le numesc cu eufemism „halucinații" — în producție, sunt erori de încredere. Noi ancorăm output-ul strict în baza ta de date: dacă răspunsul nu există în corpus, modelul refuză să-l scoată din burtă.
Silozuri de informație
Documentația tehnică în Confluence, procedurile HR în Notion, contractele în Google Drive, log-urile în Sentry. Patru surse, niciun search unificat. Echipa cere de 10 ori același lucru pe Slack pentru că nimeni nu știe unde e răspunsul.
Securitatea datelor
Frica de a trimite date confidențiale către OpenAI e justificată. Rezolvare: endpoint-uri enterprise cu contract zero-retention sau modele open-source self-hosted (Llama 3, Mistral) pe infrastructura ta. Datele sensibile rămân în VPC-ul tău.
Ce câștigi concret
Data Ingestion Pipelines
Extracție și curățare dinamică a datelor nestructurate (PDF, docx, baze de date legacy) folosind Python.
Vector Search & Embeddings
Baze de date vectoriale optimizate pentru căutări semantice de ultra-joasă latență.
LLM Agnostic
Arhitecturi flexibile care permit comutarea între modele (Claude, Vertex AI, GPT) în funcție de cost și performanță.
Arhitectura. Stack-ul. Compromisurile.
Ingestie & ETL
Conectori pentru sursele tale reale: Confluence, Google Drive, Jira, dump-uri SQL, PDF-uri scan-ate cu OCR. Curățare, deduplicare și segmentare semantică — chunk-uri care respectă granițele logice ale documentului, cu metadate atașate pentru filtrare la retrieval.
- Python
- ETL Pipelines
- OCR
Vector Store & Retrieval
Embeddings stocate în PostgreSQL cu PgVector sau Pinecone, index HNSW pentru căutare hibridă vector + keyword. Reranking cu cross-encoder înainte de context window — doar chunk-urile cu adevărat relevante ajung la model, restul e zgomot filtrat.
- PgVector
- Pinecone
- HNSW
Orchestrare LLM & Guardrails
Strat de orchestrare care impune citații obligatorii, refuz explicit când corpusul nu conține răspunsul și logging complet pentru audit. Provider-agnostic: endpoint enterprise cu zero-retention sau model self-hosted în VPC-ul tău.
- Vercel AI SDK
- Claude
- Llama 3
Cum lucrez
- 01
Ingestie & Chunking
Extragem date din surse nestructurate — PDF-uri scan-ate, baze de date legacy, dump-uri SQL, Confluence, Google Drive. Segmentare semantică cu scripturi Python — nu rupem propozițiile în mijloc, nu pierdem context la granița de chunk.
- 02
Embedding & Vector DB
Textul devine matrice matematice (vectori dense, 1536+ dimensiuni) stocate în PostgreSQL cu PgVector sau Pinecone. Index HNSW pentru căutare hibridă (vector + keyword) cu latență sub 100ms pe milioane de chunk-uri.
- 03
Retrieval & Reranking
Top-K rezultate din vector search, apoi pas de reranking (Cohere Rerank sau cross-encoder local) care reordonează după relevanță reală pentru query. Doar top 3-5 chunks ajung în context window — restul e zgomot. LLM-ul răspunde strict din contextul livrat.
Studiu de caz
Asistentul de pe acest site — RAG peste propriul nostru conținut
Chat-ul din colțul acestei pagini e sistemul descris mai sus, rulând pe conținutul BaseTech. Corpusul are 135 de articole plus 13 pagini de site (servicii, ghiduri de cost, despre), segmentate în 1.697 de fragmente vectorizate. Nu există bază de date vectorială: vectorii stau în MongoDB ca simple liste de numere, iar căutarea rulează exhaustiv în memoria aplicației — la scara asta e exactă prin construcție și costă sub 1% din latența unui răspuns. Pragul de relevanță nu e ales din intuiție, ci calibrat pe un set golden de întrebări reale, dintre care unele nu au răspuns în corpus: sub prag, asistentul spune că nu știe și îți arată ce a căutat, în loc să improvizeze. Pasajele afișate sunt scrise de server înainte de generare, deci sursa de sub răspuns e garantat reală. Întreabă-l orice de pe acest site și verifică singur.
- Surse indexate
- 135 + 13
- Fragmente vectorizate
- 1.697
- Recall@6 pe golden set
- 30/34
- Întrebări de blog pe locul 1
- 24/24
- Abțineri corecte
- 6/6
- Căutare pe corpus complet
- 5,7 ms
Întrebări frecvente
Modelul AI ne va antrena datele?
Nu. Folosim exclusiv endpoint-uri API enterprise cu zero-data-retention contractuală (Anthropic, OpenAI Enterprise tier) sau ridicăm Llama 3 / Mistral on-premise pe infrastructura ta. Datele tale nu intră în training corpus. Punct.Trebuie să avem datele perfect structurate înainte?
Nu. Pipeline-urile ETL curăță, normalizează și vectorizează date nestructurate din Google Drive, Confluence, Jira, dump-uri SQL legacy, PDF-uri scan-ate. Datele tale rămân în loc — noi indexăm peste.Cum preveniți halucinațiile?
Temperature=0 plus system prompt strict: dacă informația nu există în chunk-urile recuperate (context window), modelul răspunde „Informația lipsește din baza de date" — nu inventează. Plus citații obligatorii pe fiecare răspuns, pentru audit. Halucinația devine vizibilă, nu mascată.Cât durează și cât costă un POC RAG?
POC-ul standard: 2–3 săptămâni pe un subset real din datele tale, cu interfață de test și metrici de acuratețe măsurate, nu estimate. Costul depinde de volumul și starea datelor — după auditul gratuit primești plan fix plus estimare de cost, fără surprize pe parcurs.Ne integrăm cu aplicațiile existente sau trebuie interfață nouă?
Integrăm unde lucrează echipa ta deja: Slack, Teams, intranet sau aplicația voastră internă, prin API. Interfața dedicată e o opțiune, nu o obligație. RAG-ul e un backend — îl expunem oriunde ai nevoie de răspunsuri.Ce se întâmplă când adăugăm documente noi?
Pipeline-ul de ingestie rulează continuu sau programat: documentele noi sunt vectorizate și indexate automat, fără reprocesarea completă a corpusului. Răspunsurile reflectă starea curentă a documentației, cu data sursei inclusă în citație.
Continuă explorarea
Soluții similare
- servicii financiare
Sisteme RAG pentru eficientizarea analizei documentelor în servicii financiare
- producție
Sisteme RAG pentru acces rapid la documentația tehnică industrială
- documentație internă
Automatizarea accesului la documentație internă prin sisteme RAG
- avocatură
Sisteme RAG pentru analiza eficientă a documentelor în cabinete de avocatură
- clinici
Sisteme RAG pentru acces rapid la istoricul medical al pacienților
- suport clienți
Automatizarea răspunsurilor pentru suport clienți prin sisteme RAG personalizate
Articole conexe din blog
GPT-6 explicat: Astra, Sol și Luna, prețuri și ce model alegi
GPT-6 nu e un singur model, ci patru. Afli ce fac Astra, 6.1 Sol și Luna, cât costă în API, ce alegi pentru RAG și agenți și ce se strică la migrare.
RAG pe procedurile de urgență: documentul se execută
Planul de intervenție se aplică în minute, prin fum și fără curent. Ce cere asta de la un sistem de retrieval: mod degradat, rol pe tură, cronometru.
RAG pe nomenclatorul arhivistic: ștergerea ca obligație
Pe o arhivă, răspunsul corect poate fi că documentul nu mai trebuie să existe. Cum distinge sistemul o absență legitimă de o pierdere reală.
RAG pe documentația SSM: absența dovezii e chiar fapta
„Nu găsesc fișa" acoperă trei fapte diferite, cu consecințe diferite. Pe documentația SSM, absența unei înregistrări e ea însăși contravenția.
Pornește un POC RAG în 2-3 săptămâni
Audit gratuit pe datele tale, plan POC și estimare cost. Răspuns în 24 ore.
Discută POC RAG